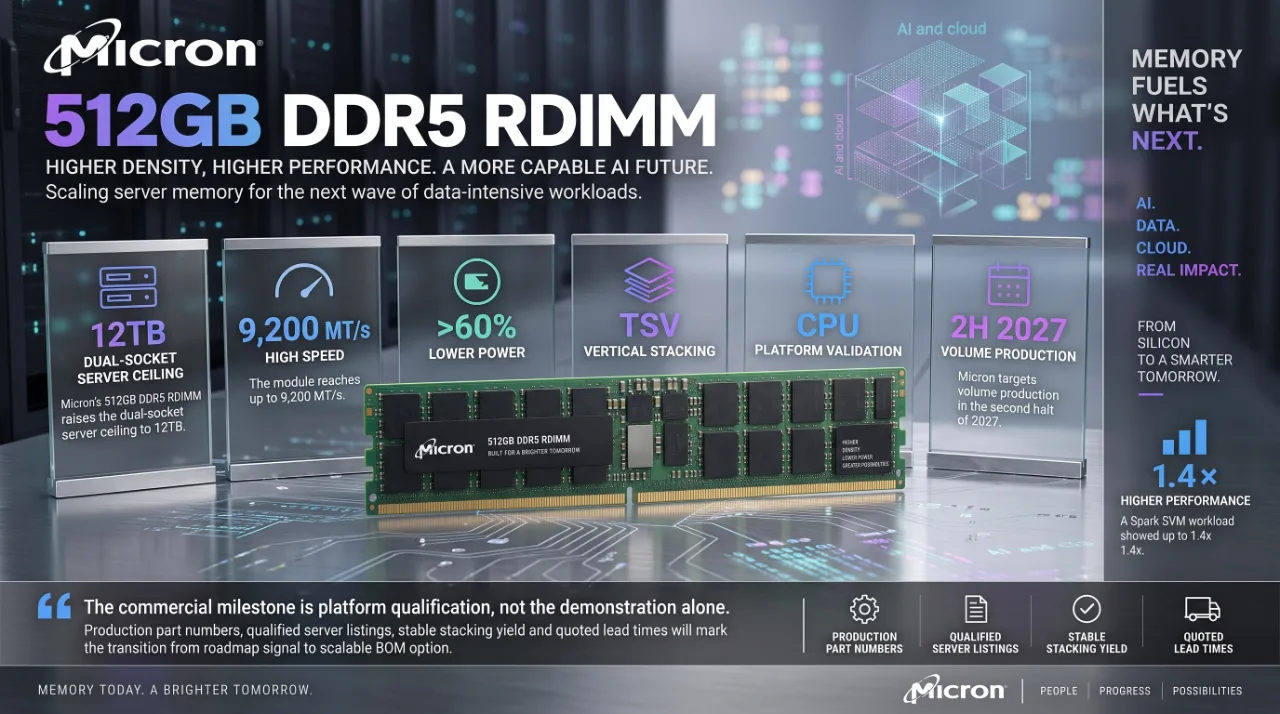
แรม DDR5 512GB จาก Micron Technology ได้สร้างมาตรฐานใหม่ให้กับวงการฮาร์ดแวร์ระดับองค์กร หลังจากการประกาศเปิดตัวโมดูลหน่วยความจำความจุ 512GB ต่อแถวเป็นครั้งแรกของโลกอย่างเป็นทางการ เพื่อตอบสนองความต้องการด้านทรัพยากรประมวลผลที่กำลังเติบโตอย่างก้าวกระโดดในตลาดดาต้าเซ็นเตอร์ 📍 นวัตกรรมดังกล่าวไม่ได้มอบเพียงความจุระดับมหาศาลเท่านั้น แต่ยังทำความเร็วในการส่งข้อมูลได้สูงถึง 9,200 MT/s ซึ่งช่วยยกระดับแบนด์วิดท์ของระบบขึ้นอย่างมีนัยสำคัญ เมื่อนำไปติดตั้งบนแพลตฟอร์มเซิร์ฟเวอร์ยุคถัดไปทั้งจาก Intel และ AMD ในรูปแบบ 2 ซ็อกเก็ต 24 สล็อต โมดูลรุ่นนี้จะทำให้เซิร์ฟเวอร์หนึ่งเครื่องรองรับหน่วยความจำรวมได้สูงสุดถึง 12TB การเพิ่มขึ้นของความจุและประสิทธิภาพในลักษณะนี้ช่วยลดปัญหาคอขวดด้านหน่วยความจำได้อย่างตรงจุด ส่งผลให้การฝึกอบรมโมเดลภาษาขนาดใหญ่ (LLMs) และการวิเคราะห์ข้อมูลเชิงลึกสามารถประมวลผลแบบ In-Memory ได้รวดเร็วและต่อเนื่องยิ่งขึ้นกว่าที่เคยเป็นมา
นวัตกรรมการผลิต TSVs สู่ประสิทธิภาพและความจุระดับ 12TB บนแพลตฟอร์มองค์กร
เบื้องหลังความสำเร็จของโมดูลรุ่นนี้อยู่ที่การนำเทคโนโลยีการวางซ้อนชิป DRAM ในแนวตั้งผสานเข้ากับการเชื่อมต่อผ่าน Through-Silicon Vias (TSVs) ซึ่งเป็นเทคนิคขั้นสูงที่ช่วยเพิ่มความหนาแน่นของหน่วยความจำบนพื้นที่แผงวงจรขนาดเท่าเดิมได้อย่างเต็มประสิทธิภาพ โดยสถาปัตยกรรมดังกล่าวช่วยให้โมดูลสามารถคงขนาดมาตรฐานสำหรับการติดตั้งในดาต้าเซ็นเตอร์ได้โดยไม่ต้องขยายฟอร์มแฟกเตอร์
นอกเหนือจากความจุและความเร็วในการทำงานแล้ว ประสิทธิภาพการใช้พลังงานถือเป็นอีกหนึ่งจุดเด่นสำคัญ โดย Micron ระบุว่าโมดูลขนาด 512GB รุ่นใหม่นี้สามารถประหยัดพลังงานลงได้มากกว่า 60% เมื่อเปรียบเทียบกับการใช้โมดูลแรมขนาด 128GB จำนวน 4 แถวเพื่อทำความจุเท่ากัน การลดการใช้พลังงานดังกล่าวนอกจากจะช่วยลดต้นทุนรวมในการเป็นเจ้าของ (TCO) ให้แก่องค์กรแล้ว ยังช่วยลดปริมาณความร้อนสะสมภายในตู้แร็ก ซึ่งเป็นอุปสรรคสำคัญของการออกแบบดาต้าเซ็นเตอร์สำหรับปัญญาประดิษฐ์ยุคใหม่
การรองรับเวิร์กโหลด AI ยุคใหม่ และแนวโน้มราคาในระดับดาต้าเซ็นเตอร์
การพัฒนาโมดูลหน่วยความจำความจุสูงนี้ มุ่งเน้นการใช้งานในกลุ่มงานที่ต้องอาศัยการประมวลผลข้อมูลปริมาณมหาศาลโดยเฉพาะ เช่น งานด้าน Data Analytics, การจัดการฐานข้อมูลขนาดใหญ่ (Big Data) และการประมวลผลโมเดล Deep Learning ยุคถัดไป ซึ่งความเร็วการส่งข้อมูลระดับ 9,200 MT/s จะเข้ามาช่วยลดความหน่วงในการเข้าถึงข้อมูลของโปรเซสเซอร์ระดับสูงได้อย่างมีประสิทธิภาพ
ในด้านการวางจำหน่าย แม้ทาง Micron จะยังไม่ได้เปิดเผยราคาจำหน่ายอย่างเป็นทางการ แต่เนื่องจากผลิตภัณฑ์ดังกล่าวเป็นฮาร์ดแวร์เกรดองค์กรขั้นสูงที่ใช้เทคโนโลยีการผลิตที่ซับซ้อน ผู้เชี่ยวชาญในอุตสาหกรรมจึงประเมินว่าราคาต่อหนึ่งโมดูลน่าจะอยู่ในระดับหลักแสนบาท ซึ่งเป็นการลงทุนที่สมเหตุสมผลสำหรับกลุ่มผู้ให้บริการคลาวด์และศูนย์วิจัยชั้นนำที่ต้องการเพิ่มความหนาแน่นของหน่วยความจำสูงสุดต่อตู้แร็ก
เทคโนโลยี Through-Silicon Via (TSV) ถือเป็นหัวใจสำคัญทางวิศวกรรมที่ทำให้ Micron สามารถผลิตแรม DDR5 ความจุสูงถึง 512GB ต่อแถวได้สำเร็จ โดยข้ามผ่านข้อจำกัดทางกายภาพของการผลิตแพ็กเกจหน่วยความจำแบบดั้งเดิม
1. หลักการทำงานของ Through-Silicon Via (TSV)
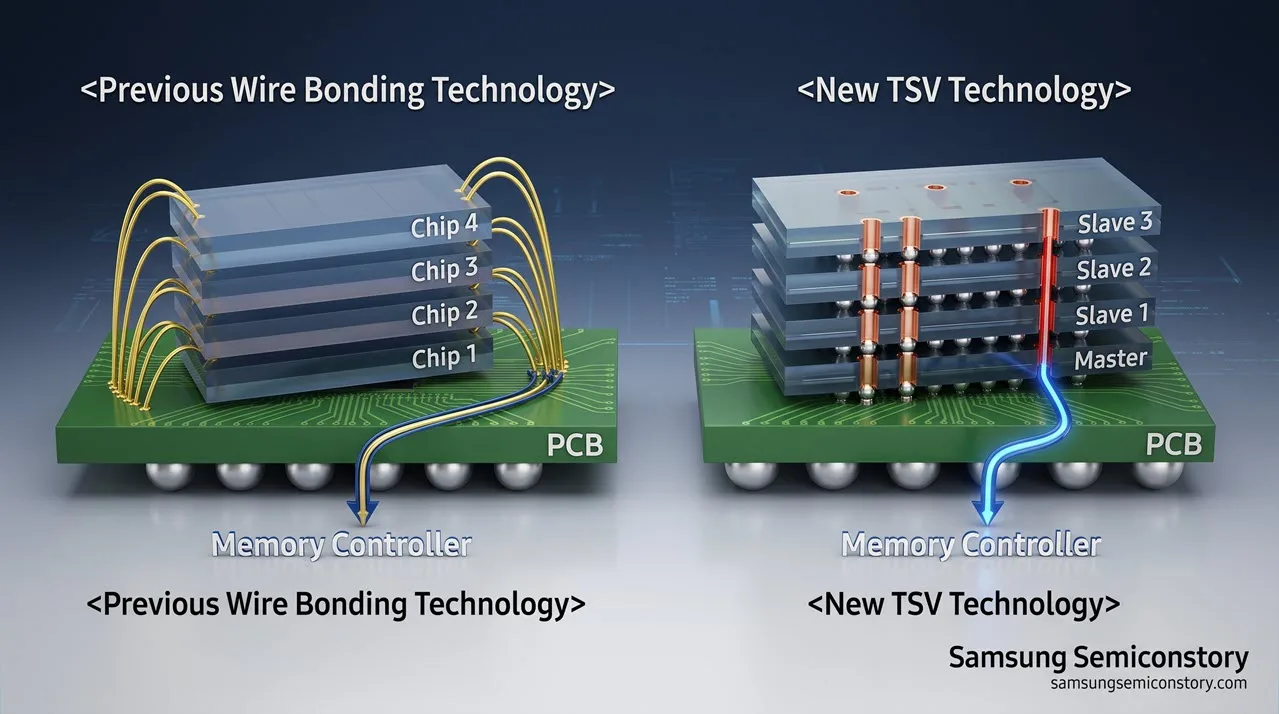
ในอดีต การเพิ่มความจุชิป DRAM ในแนวตั้งจะใช้เทคนิค Wire Bonding ซึ่งเป็นการซ้อน Die แล้วโยงสายทองคำขนาดเล็กจากขอบของแต่ละแผ่นลงมายังแผงวงจรด้านล่าง วิธีนี้มีข้อจำกัดเรื่องความยาวสาย ความต้านทานไฟฟ้า และสัญญาณรบกวน (Crosstalk) เมื่อซ้อนกันหลายชั้น
TSV แก้ปัญหานี้ด้วยสถาปัตยกรรมแนวตั้งแท้จริง (3D Stacking):
-
การเจาะรูระดับไมโครเมตร: ผู้ผลิตจะเจาะรูขนาดเล็กระดับไมครอนทะลุผ่านเนื้อซิลิคอน (Silicon Die) แต่ละชั้นในแนวตั้งฉาก
-
เชื่อมต่อด้วยตัวนำโลหะ: เคลือบฉนวนและเติมสารตัวนำไฟฟ้า (โดยทั่วไปคือทองแดง หรือ Copper – Cu) ลงไปในรู เพื่อสร้างเป็นเสาสื่อสารสัญญาณไฟฟ้า
-
เชื่อมต่อระหว่างชั้นด้วย Micro-bumps: วางซ้อนแผ่นเวเฟอร์ DRAM เข้าด้วยกัน โดยมีจุดบัดกรีขนาดจิ๋วประกบระหว่างรู TSV ของแต่ละแผ่น ทำให้ข้อมูลส่งผ่านระหว่างเลเยอร์ได้โดยตรงในระยะทางที่สั้นที่สุด
2. จุดเด่นเชิงวิศวกรรมบนแรม DDR5 ความจุสูง
| คุณสมบัติ | Wire Bonding แบบดั้งเดิม | สถาปัตยกรรม TSV บน DDR5 |
| เส้นทางการเดินสัญญาณ | อ้อมผ่านขอบชิป (ระยะทางยาว) | พุ่งตรงทะลุแนวตั้ง (ระยะทางสั้นมาก) |
| ความหนาแน่น I/O | ต่ำ จำกัดด้วยพื้นที่ขอบ Die | สูงมาก ทำได้หลายพันจุดเชื่อมต่อ |
| ความต้านทานและสัญญาณรบกวน | สูงที่ความถี่ระดับสูง | ต่ำมาก ส่งผลให้ดันความเร็วได้ถึง 9,200 MT/s |
| ความหนาของแพ็กเกจ | หนาขึ้นอย่างรวดเร็วเมื่อซ้อนชั้น | บางลงผ่านเทคนิคเจียรแผ่นเวเฟอร์ (Thinning) |
3. ทำไม TSV ถึงประหยัดพลังงานลงได้ถึง 60%?
การลดการใช้พลังงานลงกว่า 60% บนโมดูล 512GB เกิดจากปัจจัยหลักทางฟิสิกส์และระบบ:
-
ลด Parasitic Capacitance และ Resistance: ระยะทางเดินสัญญาณที่สั้นลงในระดับไมโครเมตร ทำให้ไม่ต้องใช้แรงดันไฟฟ้าสูงเพื่อขับสัญญาณ (Drive Strength) เหมือนการส่งข้อมูลผ่านสายลวดเชื่อมยาวๆ
-
รวมศูนย์วงจรควบคุม (Shared Interface Circuits): ชิปที่ซ้อนกันแบบ TSV (เช่น 8-Hi หรือ 16-Hi Die Stacks) สามารถใช้ Master-Slave Architecture โดยให้ชิปชั้นล่างสุดทำหน้าที่ควบคุมบัสสัญญาณหลักเพียงตัวเดียว ส่วนชิปด้านบนมีเฉพาะหน้าที่จัดเก็บข้อมูล ช่วยตัดวงจร I/O ที่ซ้ำซ้อนทิ้งไป
-
ประสิทธิภาพระดับโมดูล (Reduced Module Overhead): การใช้โมดูล 512GB จำนวน 1 แถว แทนโมดูล 128GB จำนวน 4 แถว ช่วยตัดการสูญเสียพลังงานจากตัวควบคุมไฟ PMIC (Power Management IC), วงจร SPD และ RCD ประจำแถวแรมลงไปได้ถึง 3 ชุด
4. ความท้าทายในกระบวนการผลิต
-
การจัดการระบายความร้อน (Thermal Dissipation): การอัดแน่นของทรานซิสเตอร์หลายพันล้านตัวในแนวตั้งทำให้ความร้อนสะสมที่แกนกลางชิปสูง จำเป็นต้องใช้สารยึดติดและวัสดุกระจายความร้อน (TIM) ชนิดพิเศษ
-
ความเที่ยงตรงระดับนาโนเมตร (Alignment & Yield): รู TSV หลายหมื่นรูในแต่ละ Die ต้องประกบลงบน Micro-bumps ให้ตรงกันอย่างสมบูรณ์แบบ หากมีเพียงไม่กี่จุดเสียหาย ทั้งแพ็กเกจจะไม่สามารถทำงานได้ ซึ่งเป็นเหตุผลสำคัญที่ทำให้ต้นทุนการผลิตยังคงอยู่ในระดับสูงมากสำหรับเกรดองค์กร
แม้ทั้ง DDR5 (3DS RDIMM) สำหรับเซิร์ฟเวอร์ และ HBM3e สำหรับชิปเร่งความเร็ว AI (เช่น NVIDIA H200 หรือ AMD MI300X) จะใช้เทคนิค Through-Silicon Via (TSV) เหมือนกันเพื่อซ้อนชิป DRAM ในแนวตั้ง แต่วัตถุประสงค์การออกแบบและสถาปัตยกรรมระดับระบบแตกต่างกันอย่างสิ้นเชิง
ตารางเปรียบเทียบสถาปัตยกรรมเชิงลึก
| คุณสมบัติ | DDR5 เซิร์ฟเวอร์ (TSV / 3DS RDIMM) | HBM3e (High Bandwidth Memory) |
| ตำแหน่งติดตั้ง | เสียบผ่านสล็อต DIMM บนเมนบอร์ด | วางประกบชิป GPU บน Substrate เดียวกันผ่าน Silicon Interposer (2.5D/3D) |
| ความกว้างของบัส (Bus Width) | 32-bit ต่อ Sub-channel (รวม 64-bit ต่อโมดูล RDIMM) | กว้างมหาศาล 1,024-bit ต่อ Stack (128-bit × 8 Channels) |
| แบนด์วิดท์ (Bandwidth) | ประมาณ 70–75 GB/s ต่อแถว (ที่ 9,200 MT/s) | สูงถึง 1.15–1.2 TB/s ต่อ Stack |
| จำนวนชั้นที่ซ้อน (Stacking Depth) | นิยมซ้อน 4-Hi ถึง 8-Hi (สูงสุด 16-Hi สำหรับรุ่น 512GB) | มาตรฐาน 8-Hi ถึง 12-Hi (และพัฒนาสู่ 16-Hi) |
| บทบาทของ Base Die (ชั้นล่างสุด) | มักเป็น DRAM die ชั้นล่างที่ทำหน้าที่ Master หรือต่อตรงกับ RCD บนแผงวงจร | เป็น Logic Base Die ทำหน้าที่จัดการ BIST, Routing, PHY และทดสอบวงจรซับซ้อน |
| ความจุสูงสุดต่อหน่วย | 128GB – 512GB ต่อแถว | 24GB – 36GB ต่อ Stack (รวม 144GB–288GB บนแพ็กเกจ GPU) |
| จุดมุ่งหมายหลัก | เน้นความจุสูงสุด (Capacity Density) เพื่อเก็บข้อมูลขนาดใหญ่ในหน่วยความจำหลัก | เน้นความเร็วสูงสุด (Massive Bandwidth) เพื่อป้อน Matrix Cores ของ GPU ให้ทัน |
ความแตกต่างเชิงวิศวกรรมที่สำคัญ
1. กลยุทธ์การขยายประสิทธิภาพ: ความกว้างบัส vs ความถี่สัญญาณ
-
DDR5 (TSV): ถูกจำกัดด้วยมาตรฐานฟอร์มแฟกเตอร์ของสล็อต DIMM ทำให้ต้องส่งข้อมูลผ่านบัสสัญญาณที่แคบ (64-bit) จึงต้องผลักดันความเร็วสัญญาณนาฬิกาให้สูงมาก (เช่น 8,000–9,200 MT/s) เพื่อดึงแบนด์วิดท์ออกมาให้ได้มากที่สุด
-
HBM3e: ใช้แนวทาง “บัสกว้างพิเศษ แต่ความเร็วปานกลาง” ด้วยการเชื่อมต่อเส้นทางข้อมูลผ่าน TSV ระดับหลายพันเส้นลงสู่ Silicon Interposer ส่งผลให้ได้แบนด์วิดท์ระดับเทราไบต์ต่อวินาที (TB/s) โดยไม่ต้องดันสัญญาณนาฬิกาจนกินพลังงานสูงเกินไป
2. สถาปัตยกรรม Base Die
-
ใน DDR5 TSV เลเยอร์ล่างสุดโดยส่วนใหญ่ยังคงเป็นแผ่น DRAM ที่มีวงจรควบคุมพื้นฐาน สัญญาณยังต้องเดินทางออกจากตัวชิปผ่านแผงวงจรพิมพ์ (PCB) ของแรม ไปยังขั้วทองแดงของสล็อต DIMM ก่อนเข้าสู่ซีพียู
-
ใน HBM3e ชิ้นส่วนล่างสุดคือ Logic Base Die (ผลิตด้วยโหนดประมวลผลขั้นสูง) ทำหน้าที่เป็นสมองควบคุมทราฟฟิกข้อมูลทั้งหมด มีวงจรทดสอบในตัว (Built-In Self-Test) และเชื่อมตรงเข้ากับ Core Logic ของชิป GPU ผ่าน Interposer ในระยะห่างเพียงไม่กี่มิลลิเมตร
3. การรับมือกับความร้อนและระยะห่างทางกายภาพ
-
DDR5 TSV: ตัวชิปกระจายอยู่บนแผงแรมยาว การระบายความร้อนอาศัยแผ่นฮีตซิงก์อะลูมิเนียมและการไหลเวียนของลมในแร็กเซิร์ฟเวอร์ ความร้อนไม่ได้รวมศูนย์อยู่กับโปรเซสเซอร์โดยตรง
-
HBM3e: ถูกผนึกอยู่ใต้ฝากระดองเดียวกับตัวประมวลผลหลัก (Co-packaged) ทำให้รับภาระความร้อนร่วมกับ GPU ที่กินไฟระดับ 700W–1000W การผลิต TSV ของ HBM3e จึงต้องใช้วัสดุ Underfill คุณภาพสูง เช่น MR-MUF (Mass Reflow Molded Underfill) เพื่อนำความร้อนออกจากแกนกลางของ Die ซ้อนให้เร็วที่สุด
สรุปบทบาทในระบบ AI
-
HBM3e คือหน่วยความจำระดับ “แนวหน้า” (Tier 0/1): ทำหน้าที่เก็บ Weights และ KV Cache ขณะประมวลผลคำนวณโมเดลแบบเรียลไทม์ ซึ่งต้องการความเร็วส่งข้อมูลระดับสูงสุด
-
DDR5 TSV 512GB คือหน่วยความจำระดับ “คลังเก็บข้อมูลหลัก” (System Host Memory): ทำหน้าที่จัดเก็บชุดข้อมูลฝึกฝนขนาดใหญ่ (Data Ingestion), การจัดการ In-Memory Database, งานเตรียมข้อมูล (Data Preprocessing) และทำหน้าที่เป็นที่พักโมเดลก่อนโหลดขึ้นหน่วยความจำของการ์ดจอ
คำถามที่พบบ่อย (FAQs)
แรม DDR5 512GB สามารถนำมาใช้งานกับคอมพิวเตอร์ทั่วไป (Desktop PC) ได้หรือไม่?
ไม่สามารถทำได้ เนื่องจากโมดูลนี้เป็นแรมประเภท RDIMM ที่ออกแบบมาสำหรับแพลตฟอร์มเซิร์ฟเวอร์และเวิร์กสเตชันระดับองค์กร ซึ่งต้องใช้เมนบอร์ดและหน่วยประมวลผลเฉพาะทาง เช่น Intel Xeon หรือ AMD EPYC เท่านั้น
การเปลี่ยนมาใช้โมดูล 512GB แถวเดียวดีกว่าการใช้แรมความจุน้อยหลายแถวอย่างไร?
การใช้โมดูล 512GB ช่วยประหยัดพื้นที่สล็อตแรมบนเมนบอร์ด ทำให้ขยายความจุรวมของระบบได้สูงขึ้น และยังช่วยลดการใช้พลังงานลงได้มากกว่า 60% เมื่อเทียบกับการใช้โมดูล 128GB จำนวน 4 แถว ส่งผลให้ระบบระบายความร้อนทำงานได้อย่างมีประสิทธิภาพมากขึ้น
ความเร็ว 9,200 MT/s ส่งผลดีต่องานประมวลผล AI อย่างไร?
ความเร็วในการส่งผ่านข้อมูลที่สูงขึ้นช่วยขยายแบนด์วิดท์ระหว่างหน่วยประมวลผลและหน่วยความจำหลัก ทำให้การป้อนพารามิเตอร์ของโมเดล AI ขนาดใหญ่ทำได้รวดเร็ว ลดเวลาแฝงและช่วยให้ระบบประมวลผลชุดข้อมูลขนาดมหึมาได้โดยไม่เกิดปัญหาคอขวด
ภาพรวมนวัตกรรมหน่วยความจำ Micron DDR5 เพื่อโครงสร้างพื้นฐานยุคดิจิทัล
การเปิดตัวโมดูลหน่วยความจำความจุ 512GB ของ Micron สะท้อนให้เห็นถึงวิวัฒนาการของเทคโนโลยีสารสนเทศที่ต้องก้าวให้ทันการขยายตัวของเทคโนโลยีปัญญาประดิษฐ์และการคำนวณขั้นสูง การรวมทั้งความเร็ว ความจุ และการจัดการพลังงานที่มีประสิทธิภาพไว้ในโมดูลเดียว จะช่วยให้ผู้ให้บริการโครงสร้างพื้นฐานระบบคลาวด์และดาต้าเซ็นเตอร์สามารถเพิ่มขีดความสามารถในการประมวลผลได้อย่างคุ้มค่า พร้อมรับมือกับความท้าทายด้านข้อมูลในอนาคตได้อย่างมีเสถียรภาพ
แรม DDR5 512GB นับเป็นอีกหนึ่งก้าวสำคัญของการพัฒนาสถาปัตยกรรมหน่วยความจำสำหรับระบบประมวลผลประสิทธิภาพสูง หากคุณต้องการติดตามความเคลื่อนไหวล่าสุดเกี่ยวกับเทคโนโลยีฮาร์ดแวร์ อุปกรณ์เซิร์ฟเวอร์ คอมพิวเตอร์ประกอบ และนวัตกรรมประมวลผลปัญญาประดิษฐ์จากแบรนด์ชั้นนำทั่วโลกอย่างต่อเนื่อง สามารถคลิกกลับไปสำรวจบทความ บทวิเคราะห์เชิงลึก และ ข่าวสารเทคโนโลยี ที่น่าสนใจทั้งหมด เพื่อให้คุณไม่พลาดทุกการอัปเดตสำคัญในแวดวงไอทียุคปัจจุบันครับ